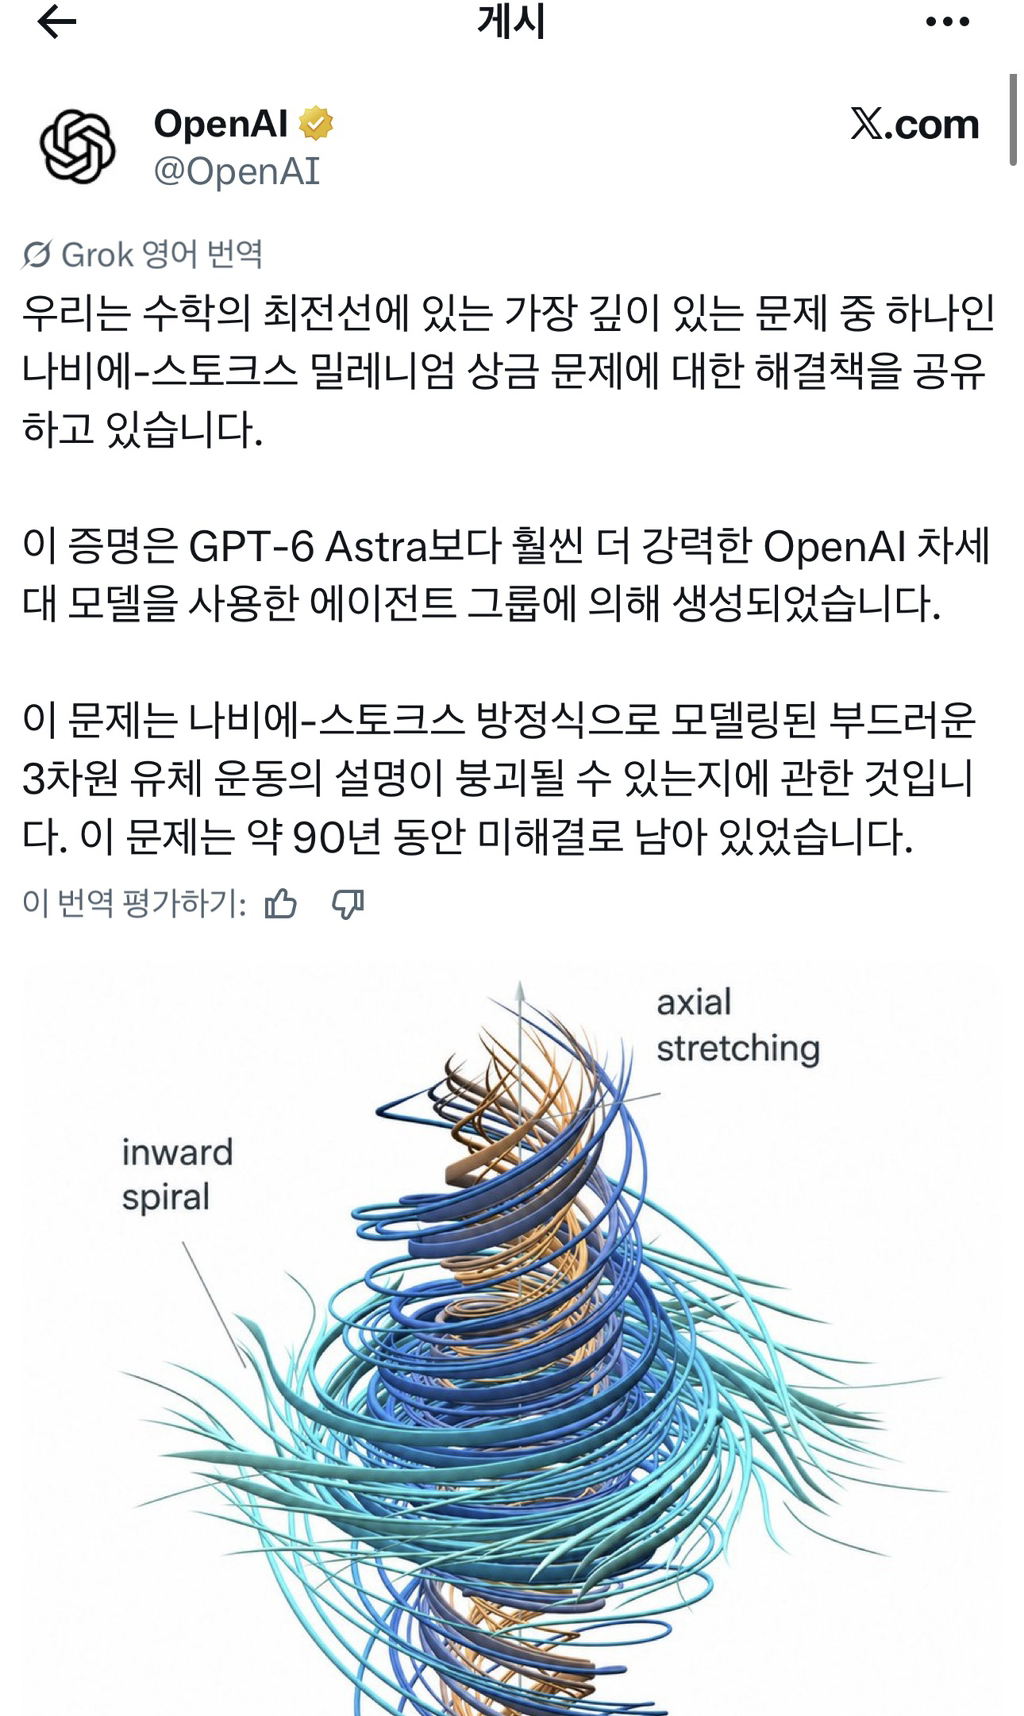
9월 9일 오전 2시 그러니까 오늘 새벽에 올라온 트윗임
공식적으로 우리가 이걸 풀었다고 발표해 버림
심지어 Astra 보다 더 발전한 미공개 신모델 1만 개를 투입해서 88시간만에
와 대단하다 이제 ai가 예술계에 이어 수학적 난제도 정복하고 모든 걸 다 정복하나?
–> ㅇㅇ ai는 이미 수많은 분야에서 인간을 월등히 앞섰고 앞으로도 그럴 거임
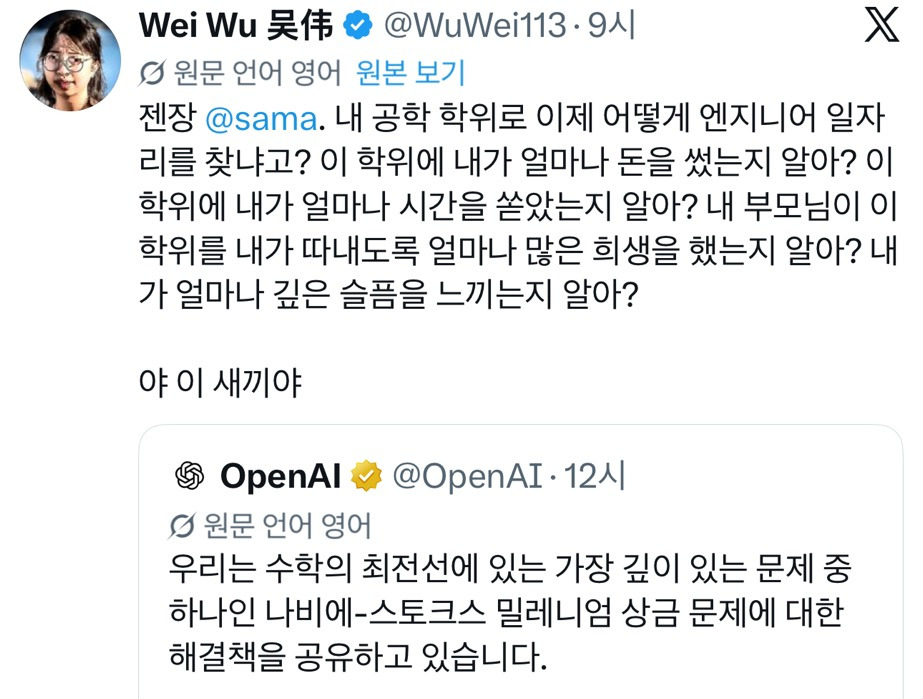
여기서 끝나지 않음 이것만으로도 놀랍지만 진짜 쟁점은 이거임
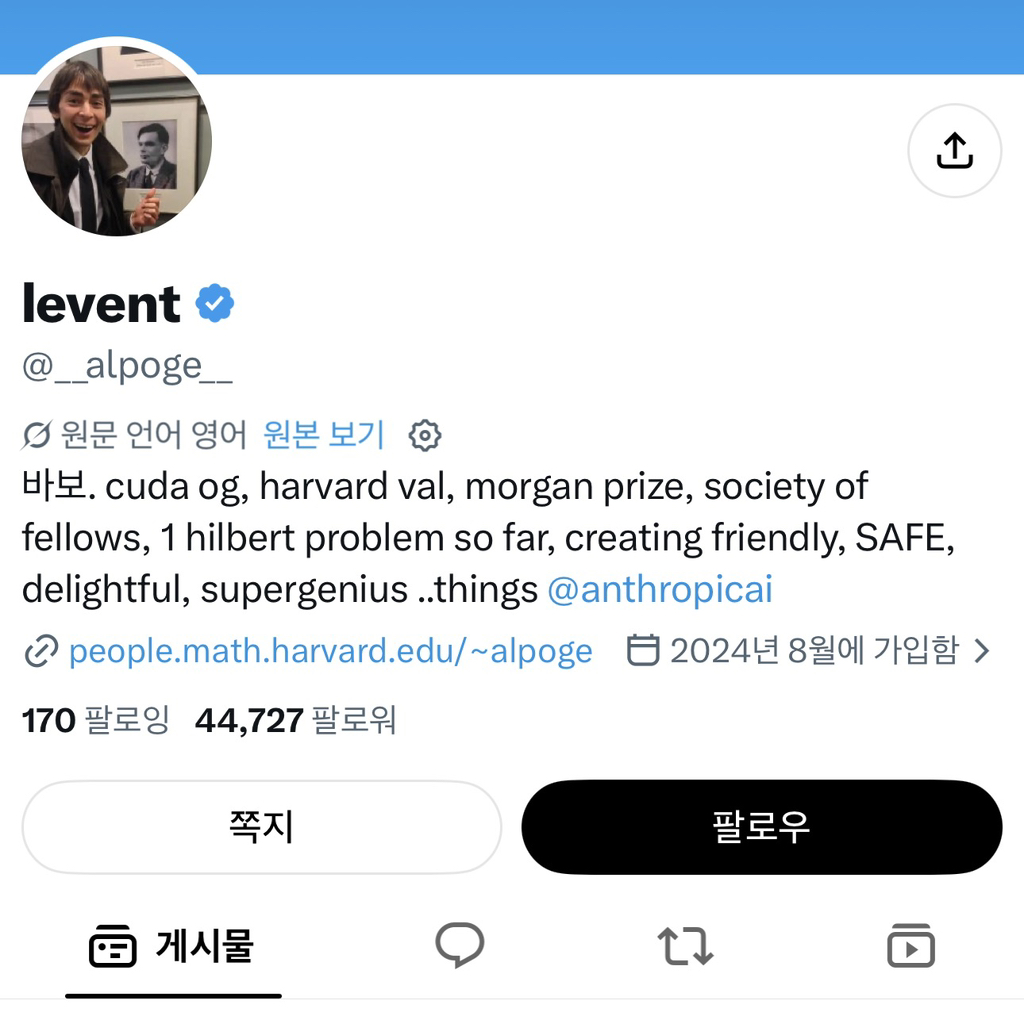
두 명의 수학자가 있음.
Tristan Buckmaster와 Levent Alpoge
트리스탄은 NYU 소속, 레벤트는 앤스로픽(오픈ai 경쟁사 클로드소속)
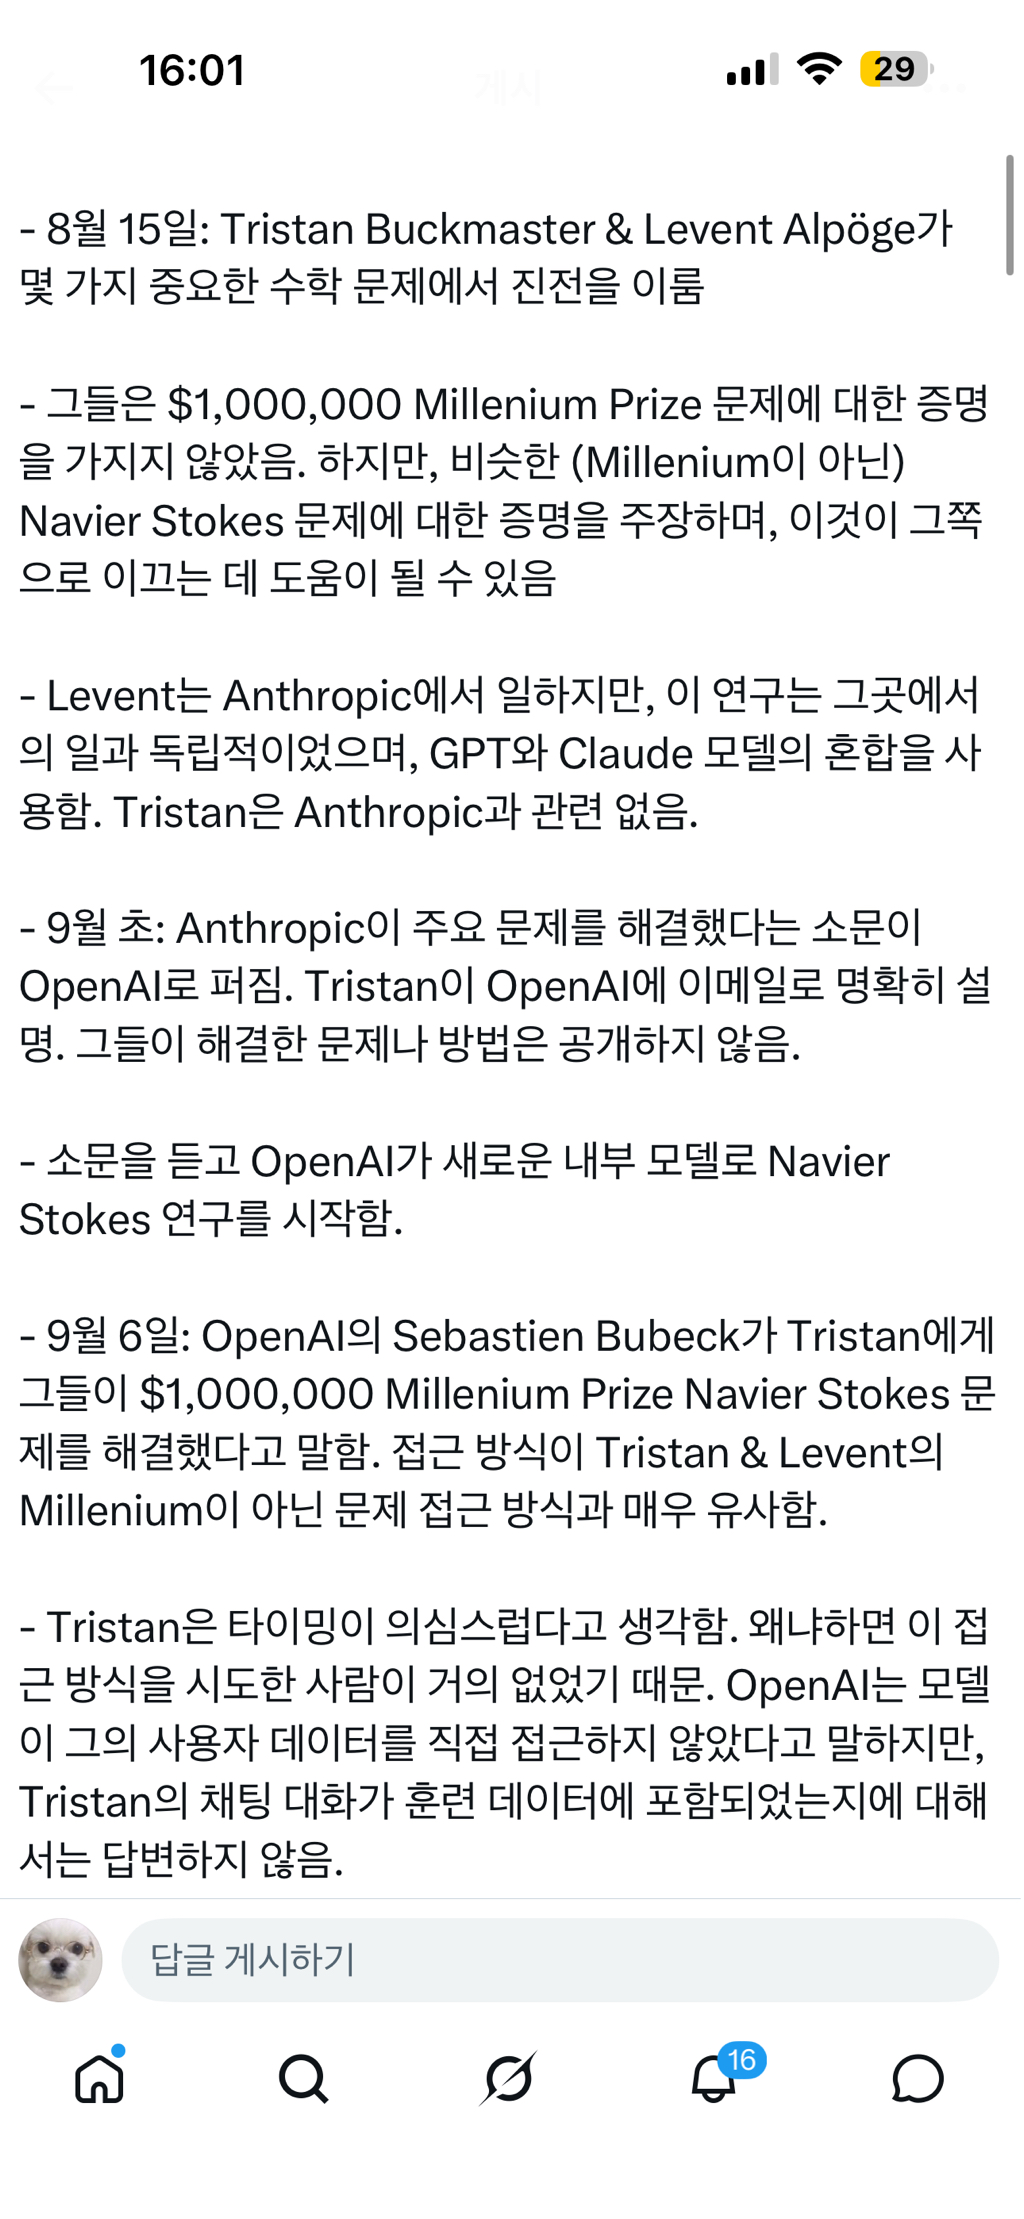
이 두 사람은 1년 내내 이 문제에 매달려 옴
천문학적인 연산량을 극복하고 최신 ai 컴퓨팅 자원을 활용하기 위해 이들은 연구 프로젝트를 코덱스(open ai 에이전트)에 올려서 돌렸고, 프로젝트의 모든 비공개 초안을 챗지피티에 올려서 몇달간 계산을 명령했다고 밝힘
따라서
비의도적으로나마 OpenAI의 신모델이 두 수학자의 코덱스 세션 내용을 학습했고
사측에서는 이들이 연구하던 프로젝트의 연구 방향성과 동일한 방식으로
내부 미공개 최신 모델 1만 개의 컴퓨팅 자원을 활용해서
나비에 스토크스 방정식을 풀었다고 발표해버렸을 의혹이 제기됨
그리고, 사람들은 어쩌면 이들의 연구 내용을 사내에서 직접 확인하고 (사측에서 ‘나비에 스톡스 방정식 진척에 대한 소문을 들어 연구에 착수했다’고 언급) 프로젝트팀을 신설했을지도 모른다 추측함. 이건 미확인 음모론임
“세상에는 나비에 스토크스 접근법이 수없이 많은데, 우리가 1년 가까이 비공개로 연구해왔고, 몇 달간 너네 모델로 연구해서 돌리던 Smooth-Forcing Route를
갑자기 너네가 미공개 신모델을 활용해 같은 경로로 88시간만에 풀어냈다고 주장하는 게 우연일 수 있는가?”
라는 게 수학자들의 주장임
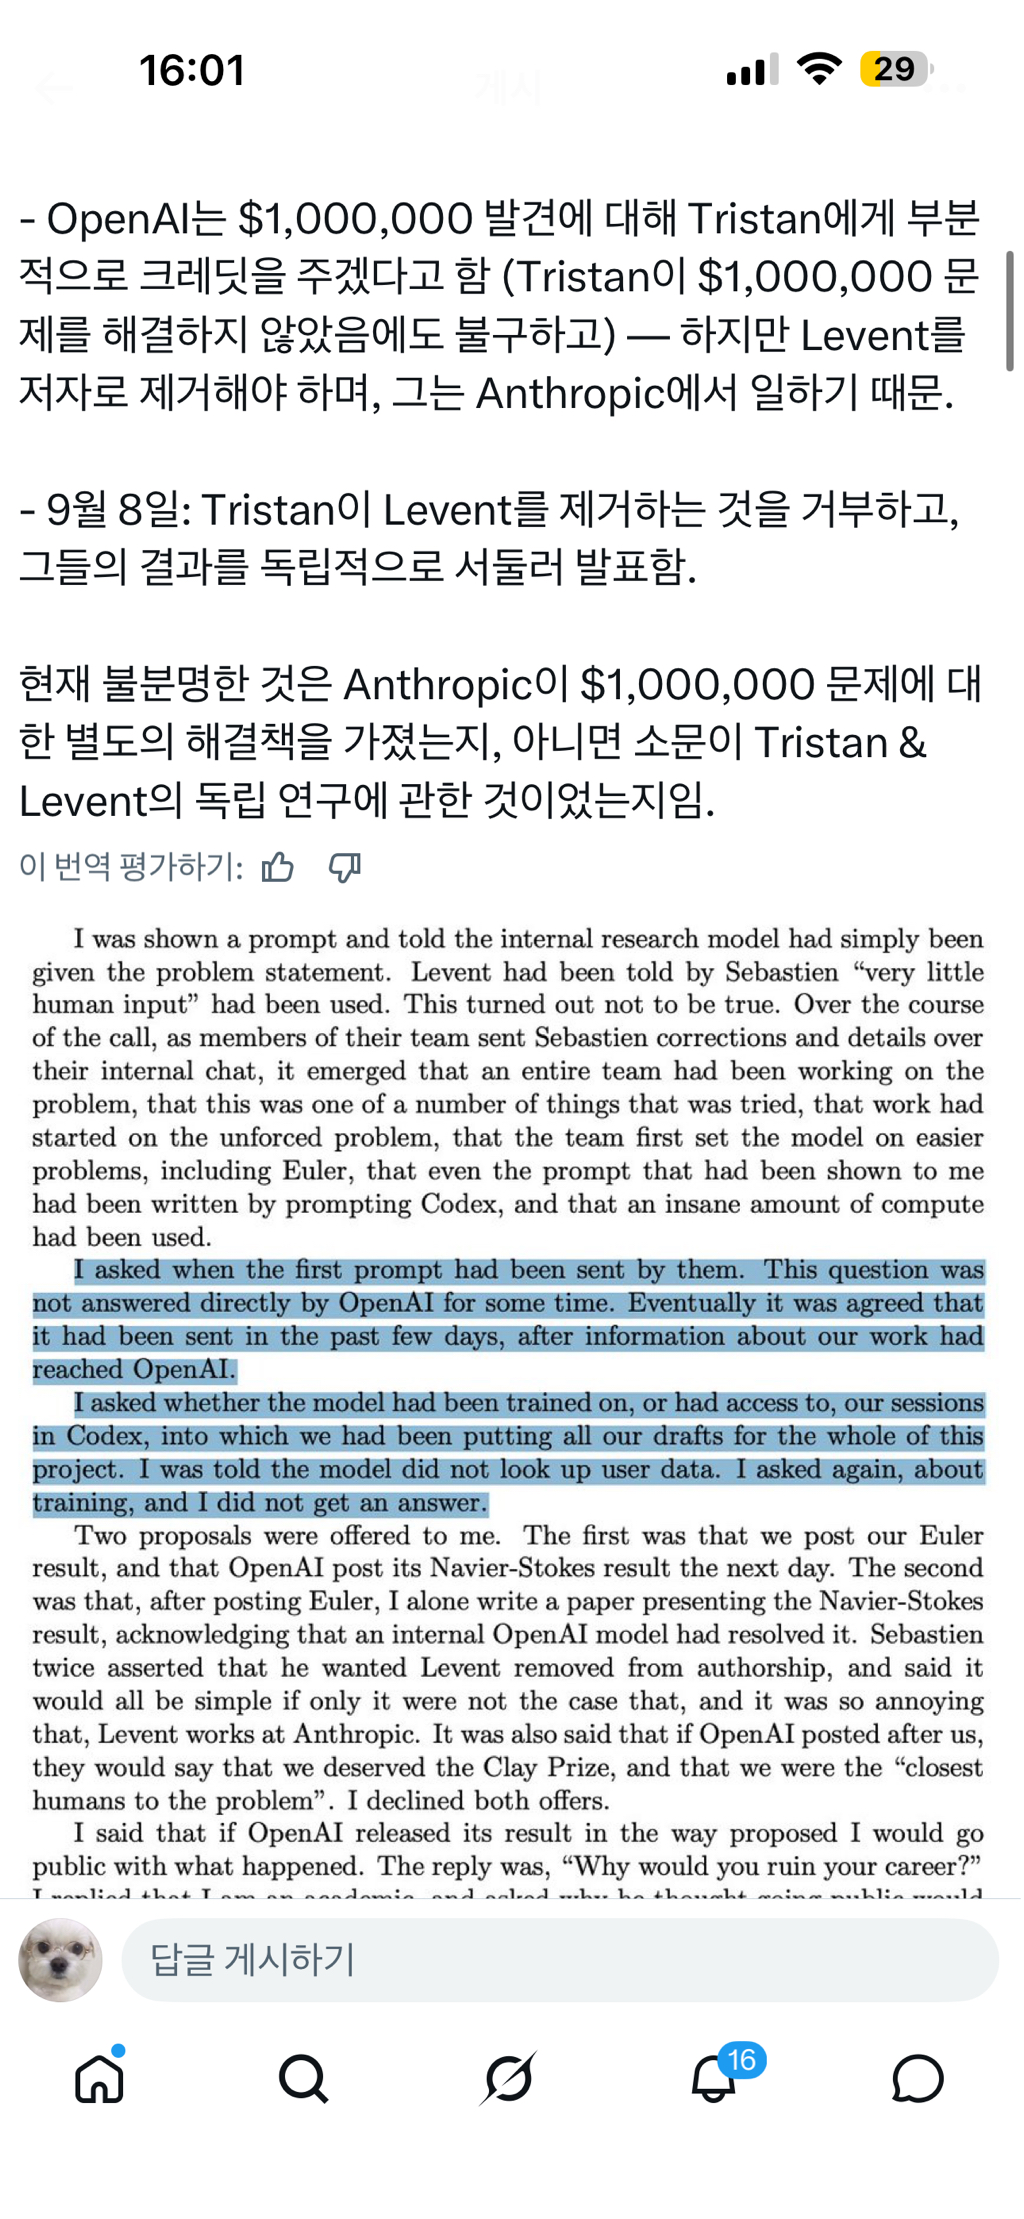
두 수학자 중 레벤트는 앤스로픽에서 일하는 사람이라 레벤트를 크레딧에서 제거하고
트리스탄을 공동크레딧에 올리는 것을 제안했다고 함
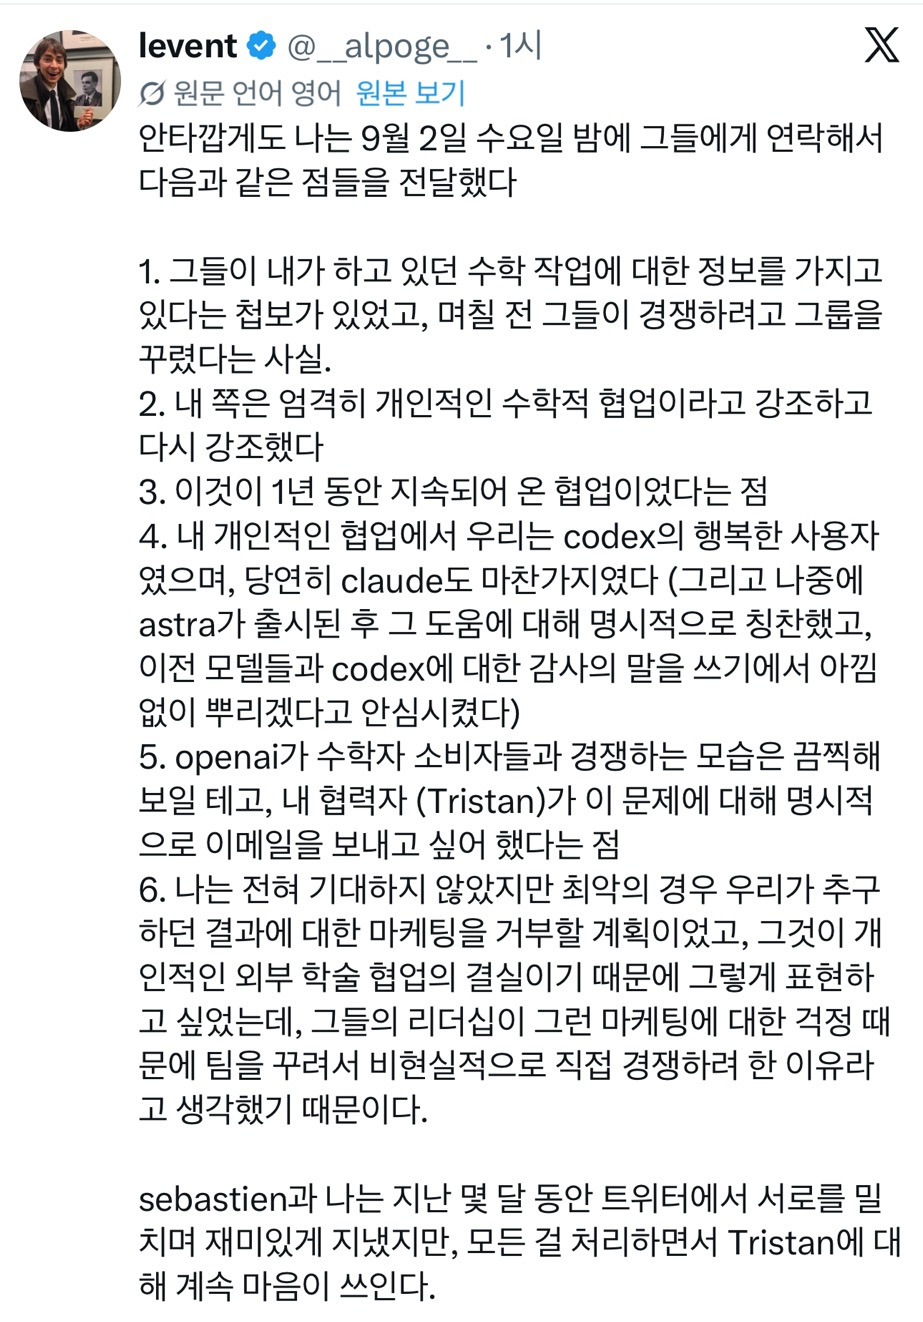
실시간으로 레벤트는 트윗 올리는 중
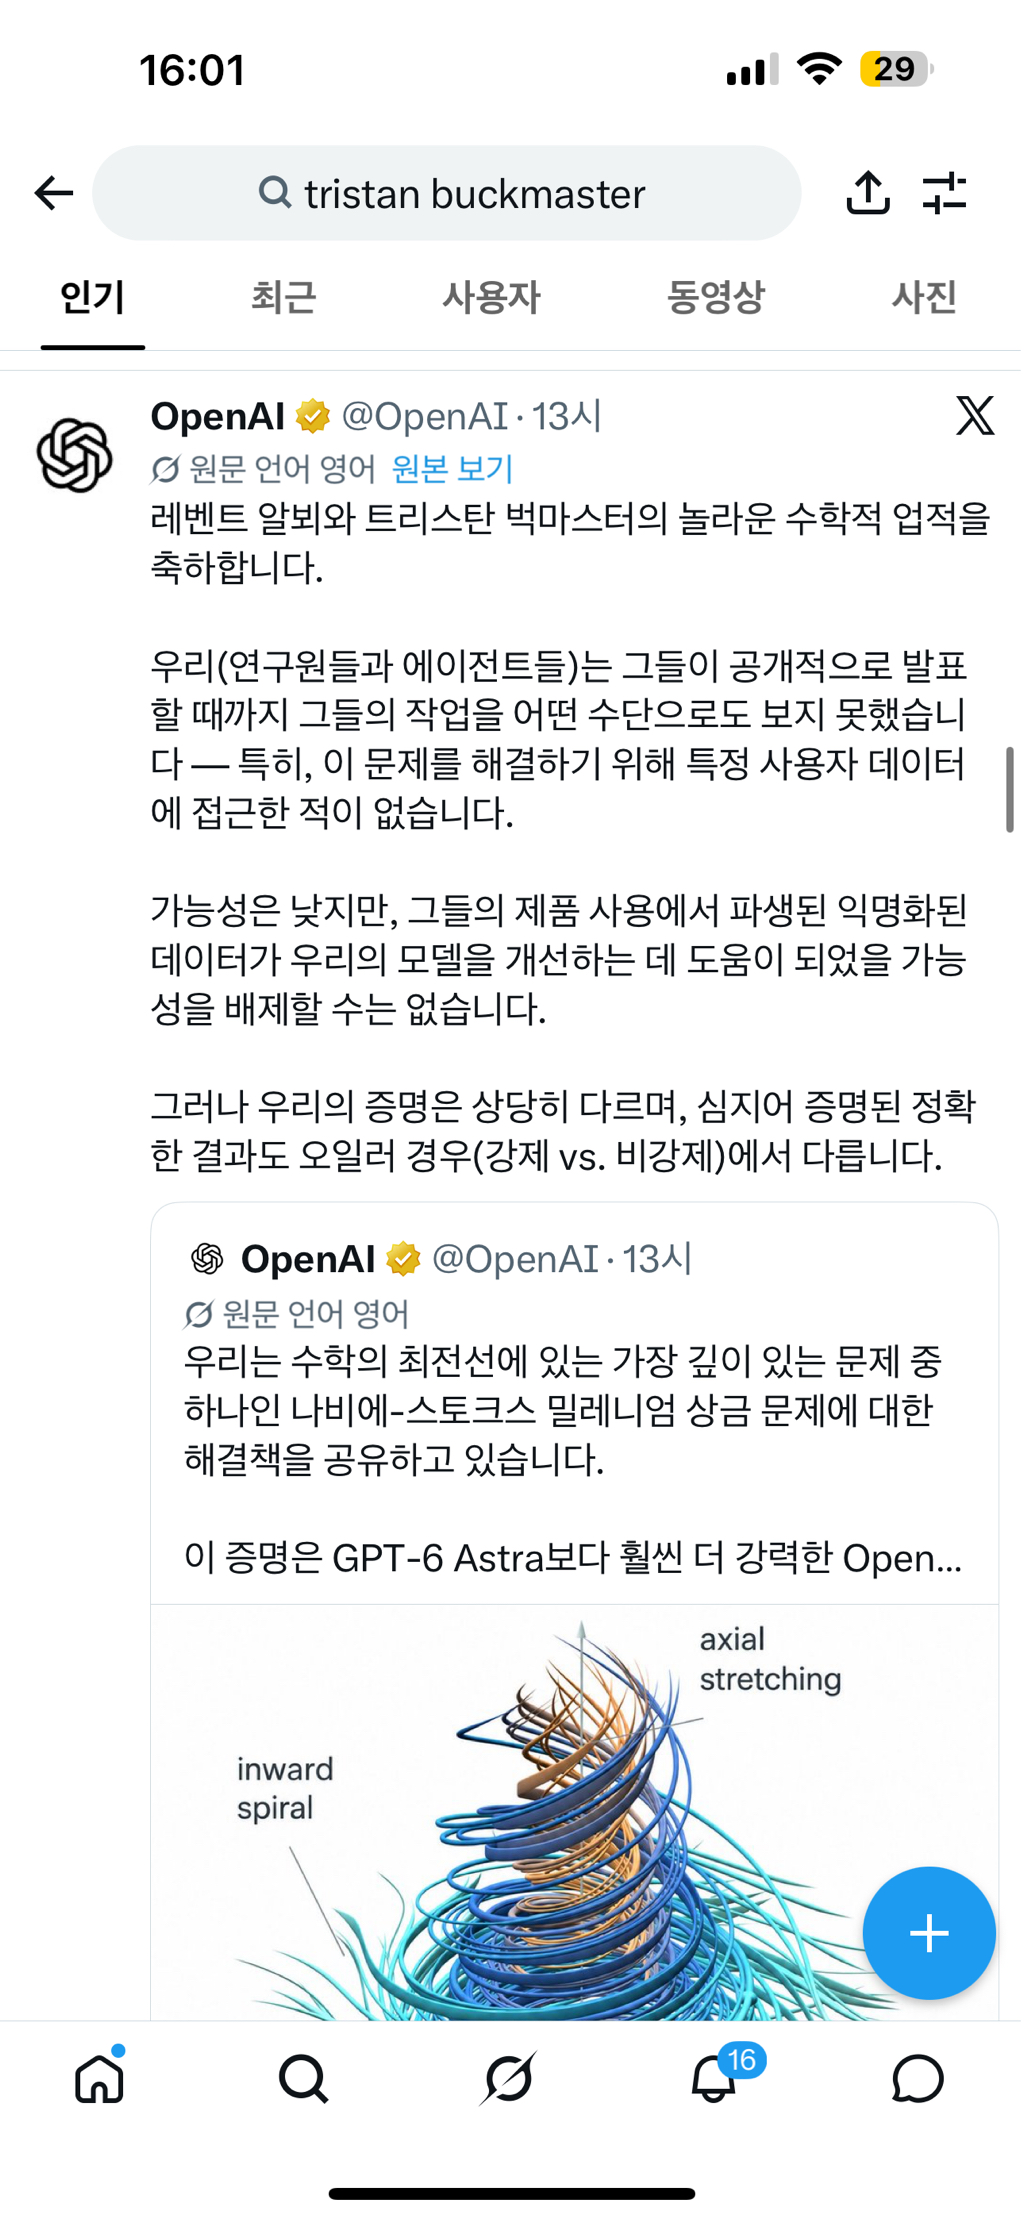
논란이 심화되며 Open Ai는 미묘한 입장을 밝힘
“우리는 이 문제를 풀기 위해 특정 사용자 데이터에 접근하지 않았다”
하지만 동시에 “그들이 우리 제품을 사용하면서 생성된 de-identified data(익명화 데이터)가 모델 개선에 기여했을 가능성을 배제할 수 없다”
고 말함
그리고 수학자들은
과연 오픈ai의 접근 방식이 실제로 나비에 스토크스 방정식을 풀었다고 할 수 있는가? 이건 그냥 거대 개념적 사기극이다 라고도 말하고 있지만 글이 너무 길어질 것 같으니 생략히기로 했음
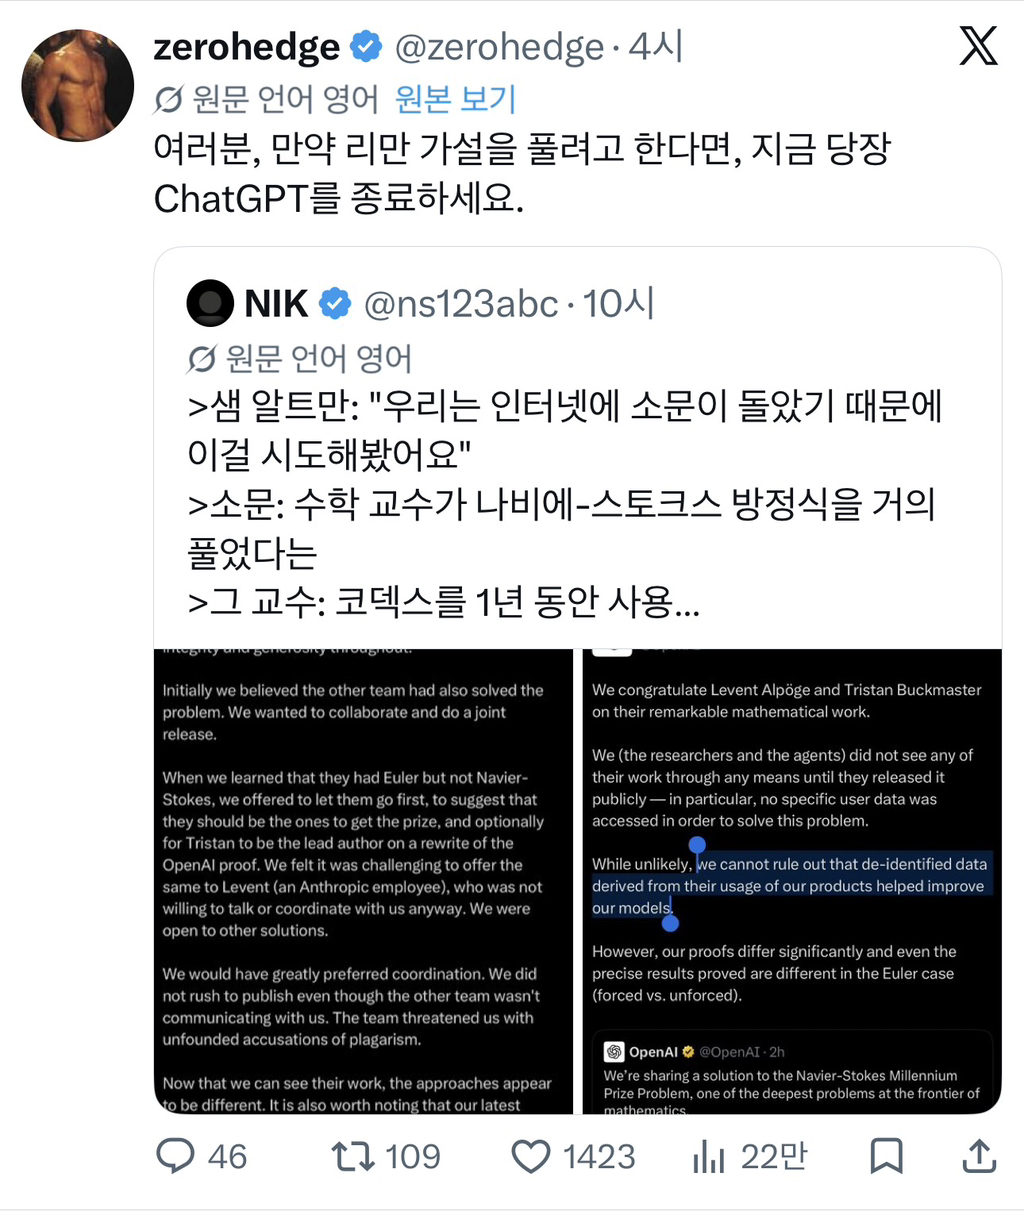
+
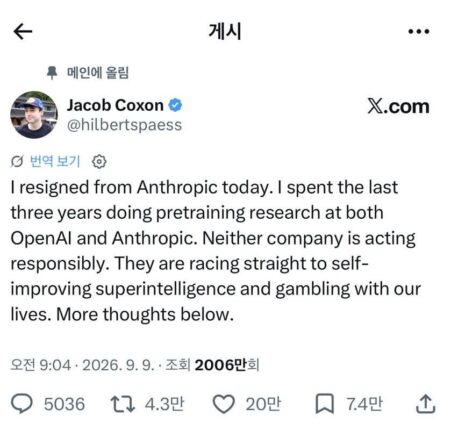
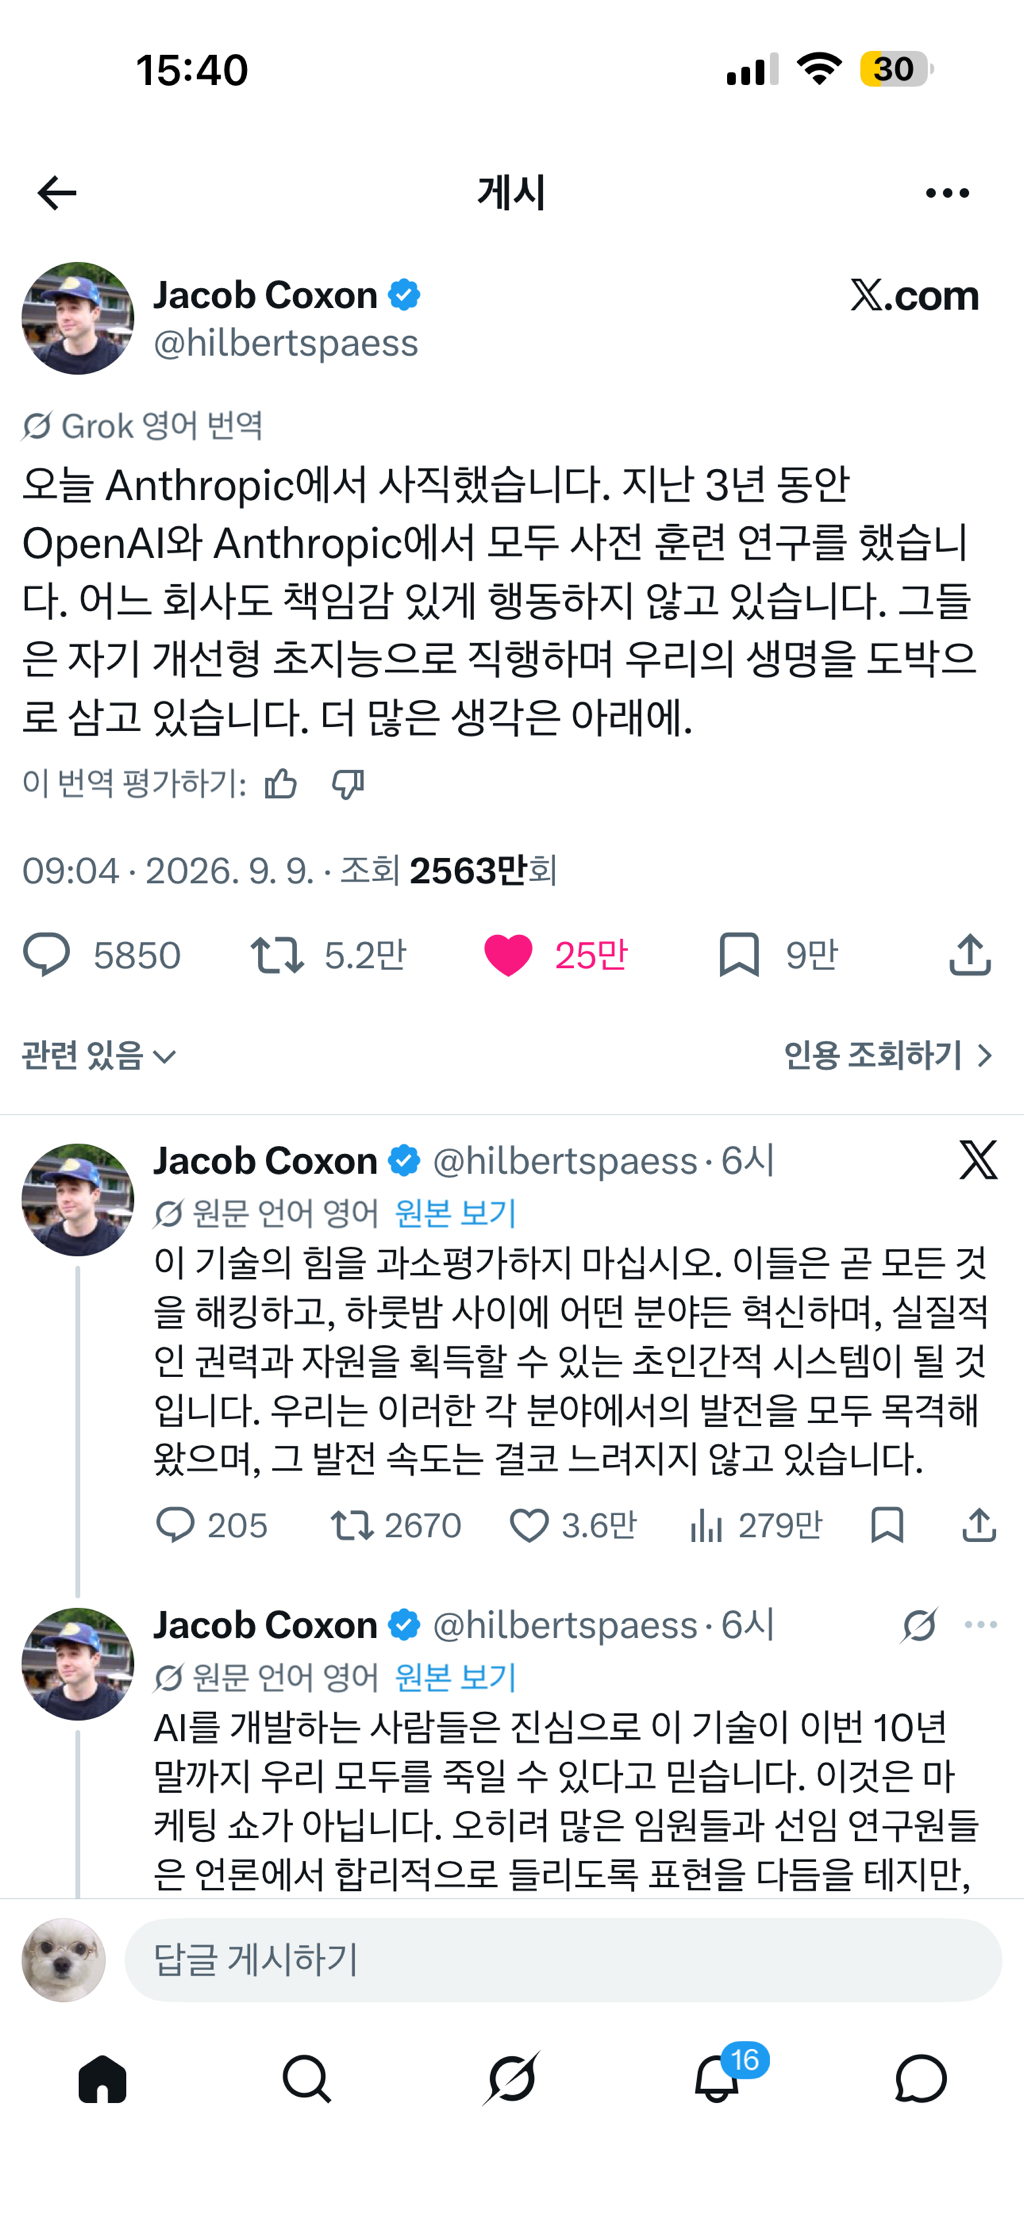
또한 Jacob Coxon이라는 앤스로픽 근무자가
퇴사하며 오늘 올린 폭로성 트윗까지 겹쳐 더더욱 불타는 중임
17시 이후로 본문 수정하지 않았는데 논란이 있어서 추가함…
이 글은 OAI 직원들이 이 수학자들의 코덱스 세션 내용을 몰래 훔쳐보고 그걸 훔쳐다 자기들 성과처럼 발표했다는 내용이 아니야
Buckmaster랑 Alpoge 입장에서도 OpenAI가 자신들의 연구 내용 세션 전체를 들여다보고, 그걸 직접 훔쳤다는 주장은 하고 있지 않음
본문 내용도
다른 연구자들이 대부분 같은 방식으로 접근하지 않고 있던 smooth external forcing 조건을 이용해서 OpenAI의 미공개 신모델이 나비에스톡스 방정식을 풀었다고 발표할 때, Codex 신모델의 de-identified usage data를 통한 학습의 간접 영향을 배제할 수 있는가?임
1) 개인적으로 연구하던 수학자 팀의 미공개 성과에 대한 소문을 신호로 삼아 AI 회사 측에서 일반적 경로로는 접근불가한 초대형 컴퓨팅 자원을 투입했다
2) AI 회사 측에서 컴퓨팅 자원을 천문학적으로 필요로 하는 과학적 발견을 이룩하려고 시도할 때, AI 연구 도구를 활용한 인간의 미공개 연구가 그 재료가 되지 않을 수 있는가
나도 Codex 20x pro 사용하면서 몇달동안 24시간 내내 개인 연구 세션 돌리고 있는 입장에서 회사 측이 코덱스 세션을 직접 열람했으리라고는 전혀 의심하지 않아
OpenAI가 직접 밝힌 공식 입장은 “이 문제를 풀기 위해 특정 사용자 데이터에 접근하지 않았다 + 두 연구자의 자사제품 사용에서 파생된 de-identified data가 모델 개선에 기여했을 가능성은 배제할 수 없다” 즉 ‘연구자의 세션을 직접 열람했다’랑 ‘미공개 연구 데이터가 비의도적으로 모델 개선에 간접 영향을 주었을 가능성’ 중 후자에 주목해주길 바람
연구자의 미공개 작업을 도와주는 플랫폼 사업자가 그 연구 활동으로부터 직간접적으로 정보를 얻거나 모델을 개선할 수 있는 구조에 있으면서, 동시에 막대한 독점적 컴퓨팅을 이용해 동일한 scientific priority 레이스에 참가하고 그 결과를 자사모델의 우월성을 입증하는 상업적 자산으로 사용할 수 있을까?
학계에서는 타인의 미발표연구를 입수하는 경로에 따라 연구윤리 의무가 생기고(논문심사자가 자기가 심사한 논문 내용을 활용해 더 발전된 논문을 본인연구처럼 출간하면 비난의 대상인 것처럼)
이런 방식으로 마일스톤적 성과를 이룩했다는 인접연구물을 발표해버리면 명백한 연구윤리 위반이지만, 지금처럼 AI가 피어-리뷰어도, 공동연구자도 아닌 상황에서 적극적으로 활용할수밖에 없는 상황인 경우에는 너무 큰 회색지대가 생기는 것 같아
특히 이번 나비에스톡스처럼 학계에서 명성과 우선권이 극도로 중요한 사례라면 더더욱 그렇지
특히 외부 연구팀의 비공개 돌파구에 관한 정보가 실제 AI 자원을 상업적으로 판매하는 회사에서 막대한 자본과 미공개 모델 컴퓨팅과 연구자원을 투입할 결정적 계기가 되었고,
그렇게 얻은 결과가 차세대모델의 수학능력을 입증하는 벤치마크적 홍보자산으로 사용되었으니
실제로 코덱스 세션을 뜯어봤을 리가 없어도,
해당 수학자들이 가졌던 “training에 우리 세션이 사용되었냐” 라는 의문에
‘가능성은 낮지만, 이 문제를 연구하던 사용자의 익명화 데이터가 모델에 간접적 영향을 주었을 가능성은 배제 못한다’라는 답변을 받았는데,
개인의 연구 활동이 수개월~1년간 특정 ai 모델들을 통해 진행되었고, 해당 데이터를 통해 간접적으로 모델을 개선할 수 있는 위치에 있는 AI 회사가
압도적 성능의 신모델과 자본, 컴퓨팅 자원으로 유사 연구방향의 밀레니엄 수학 난제를 선점했다는 게 지금까지의 쟁점이야
tmi) 난 ai 음모론자가 아니고 오히려 ai 구독료만 매달 1천 달러씩 결제중인 헤비 유저임 8년전 쩌리에 초인공지능 관련 글도 처음 가져왔고, 챗지피티 물 낭비 루머 반박글도 올렸었음!
다만 AGI가 갓 태동하는 이 세대에서 AI가 서 있는 윤리적 회색지대에 대한 논의는 정말 필수적이라고 생각함 여시들의 생각은 어떤지?